
Anonimização de documentos com IA: da remoção de dados à busca segura no acervo
 Danilo Siqueira Brito
Como combinar regras determinísticas, inteligência artificial, revisão humana e verificação técnica para proteger dados pessoais sem perder o controle sobre os documentos.
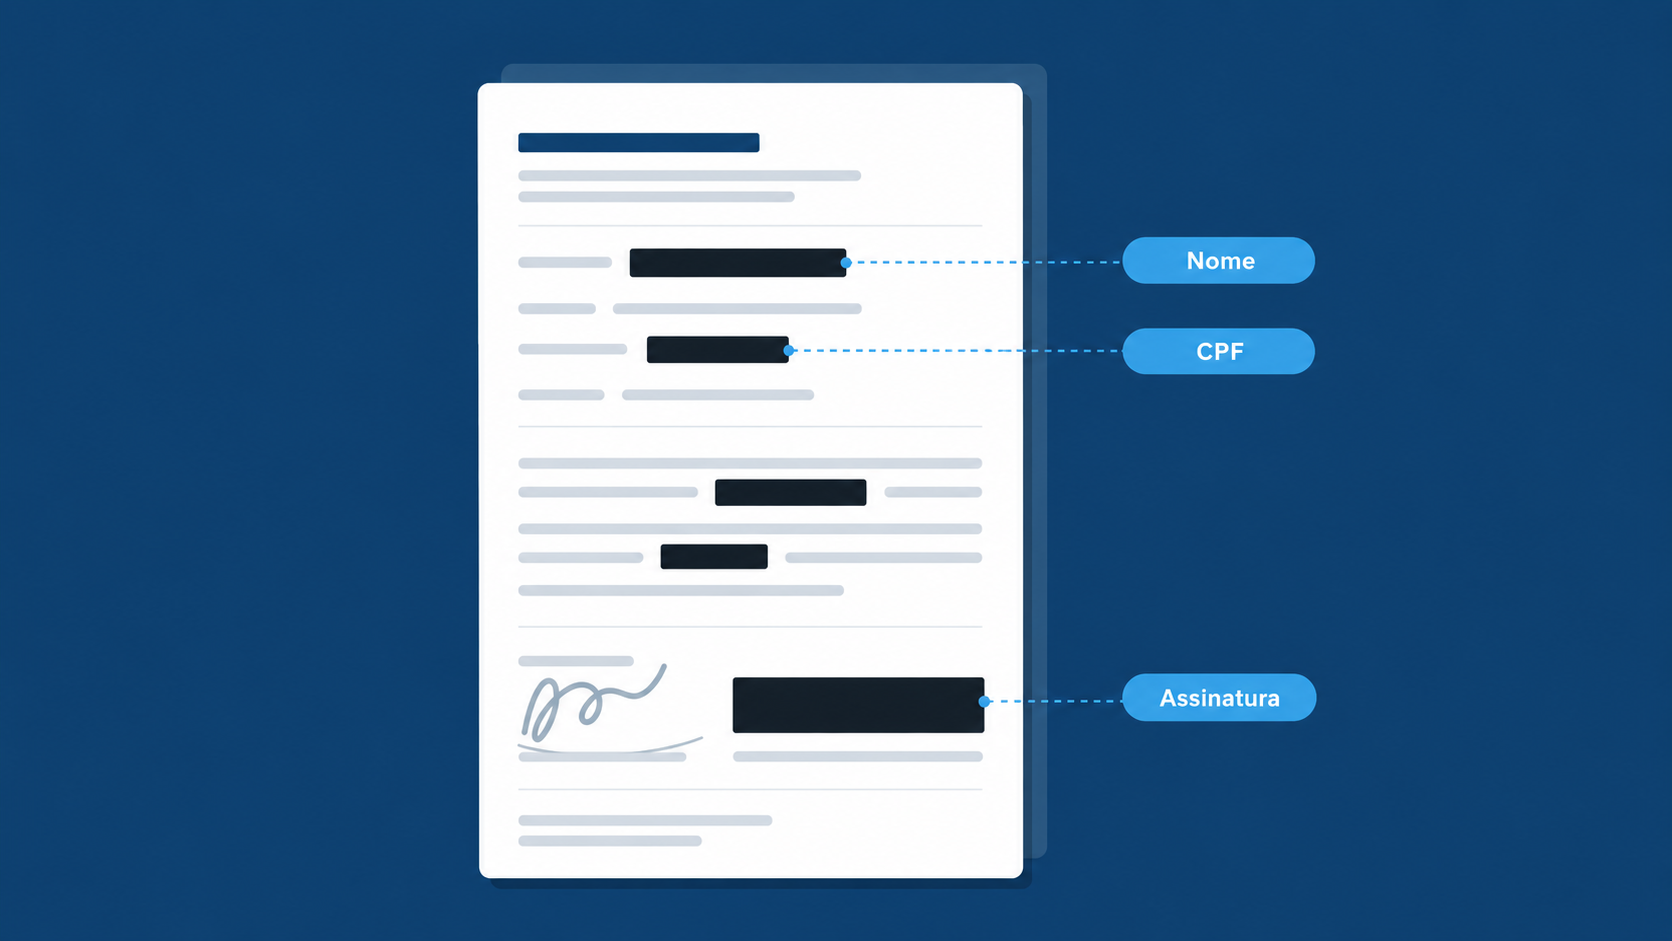
Um contrato pode exibir tarjas sobre nomes, CPFs e assinaturas e continuar entregando essas informações a quem copiar seu conteúdo. O problema está na diferença entre aquilo que o leitor vê e aquilo que o arquivo conserva. Em um acervo digital, essa diferença pode se repetir em milhares de documentos, inclusive nos índices usados para pesquisa.
A anonimização de documentos com IA precisa enfrentar esse problema em várias etapas. Primeiro, localizar informações que podem identificar uma pessoa. Depois, decidir o que deve ser removido, executar a transformação e verificar o resultado. Por fim, garantir que o dado retirado da versão de acesso não reapareça em um índice de busca, em um registro de aprendizado ou em uma cópia esquecida no fluxo.
O material técnico de Danilo Siqueira Brito, da SOS Docs, apresenta uma implementação que articula quatro agentes, revisão humana, remoção efetiva do conteúdo e busca semântica sobre versões tratadas. Este artigo desenvolve essa arquitetura e suas implicações para a gestão documental, a preservação digital e a proteção de dados. As características do sistema são aquelas relatadas pelo autor; as telas de demonstração, os protótipos e os limites da solução estão identificados ao longo do texto.
Por que uma tarja preta pode deixar o dado exposto
Um PDF reúne objetos e instruções que determinam como textos, imagens e outros elementos serão apresentados. Uma palavra pode existir como texto selecionável; uma página digitalizada pode conter uma imagem e, separadamente, uma camada de texto produzida por reconhecimento óptico de caracteres, o OCR.
Quando uma ferramenta apenas desenha um retângulo sobre uma área, acrescenta um elemento visual. O conteúdo anterior pode continuar armazenado no arquivo. O retângulo ocupa a posição superior na composição da página, mas não necessariamente elimina as letras ou os pixels que pretende esconder.
É por isso que a inspeção visual, sozinha, não comprova uma remoção. O dado pode desaparecer na leitura da página e permanecer acessível por seleção, cópia ou extração de texto. Em outros casos, o texto é removido de uma camada, enquanto a imagem original continua contendo a informação.
O PDF recorda dois episódios para ilustrar esse risco: a divulgação de um manual da TSA em 2009 e um documento apresentado à Justiça federal norte-americana em 2019. Nos exemplos citados pelo autor, o conteúdo encoberto pôde ser recuperado. O ponto técnico permanece: a aparência de uma tarja não demonstra o que aconteceu com o conteúdo do arquivo.
Ocultação, remoção e anonimização são resultados diferentes
Uma ocultação visual impede a leitura imediata de determinada área. Uma remoção efetiva retira o conteúdo selecionado da versão produzida. Já a anonimização exige avaliar se a pessoa continua identificável, inclusive pelas informações que permaneceram.
Um documento pode ter o nome corretamente removido e ainda identificar alguém como o único servidor de um setor em determinado ano. Nesse caso, a operação técnica de remoção pode ter funcionado, mas a associação indireta com o indivíduo permanece possível.
A LGPD considera os meios técnicos razoáveis e disponíveis na avaliação da anonimização. Seu artigo 12 mantém no âmbito dos dados pessoais os casos em que o processo pode ser revertido nas condições previstas na lei. 2
Também convém distinguir uma tarja mal aplicada da pseudonimização. No GDPR, esta envolve impedir a atribuição dos dados a uma pessoa sem informações adicionais, mantidas separadamente e protegidas. Deixar o texto íntegro sob um retângulo não demonstra esse tratamento. O considerando 26 exige considerar a possibilidade de identificação; pseudonimização não deve ser apresentada como sinônimo de anonimização. 3
Essa distinção orienta todo o projeto. O sistema precisa comprovar a remoção dos elementos selecionados, enquanto a organização avalia se o documento resultante ainda permite identificar pessoas e quais condições de acesso são adequadas.
A detecção começa pela regra e avança para o contexto
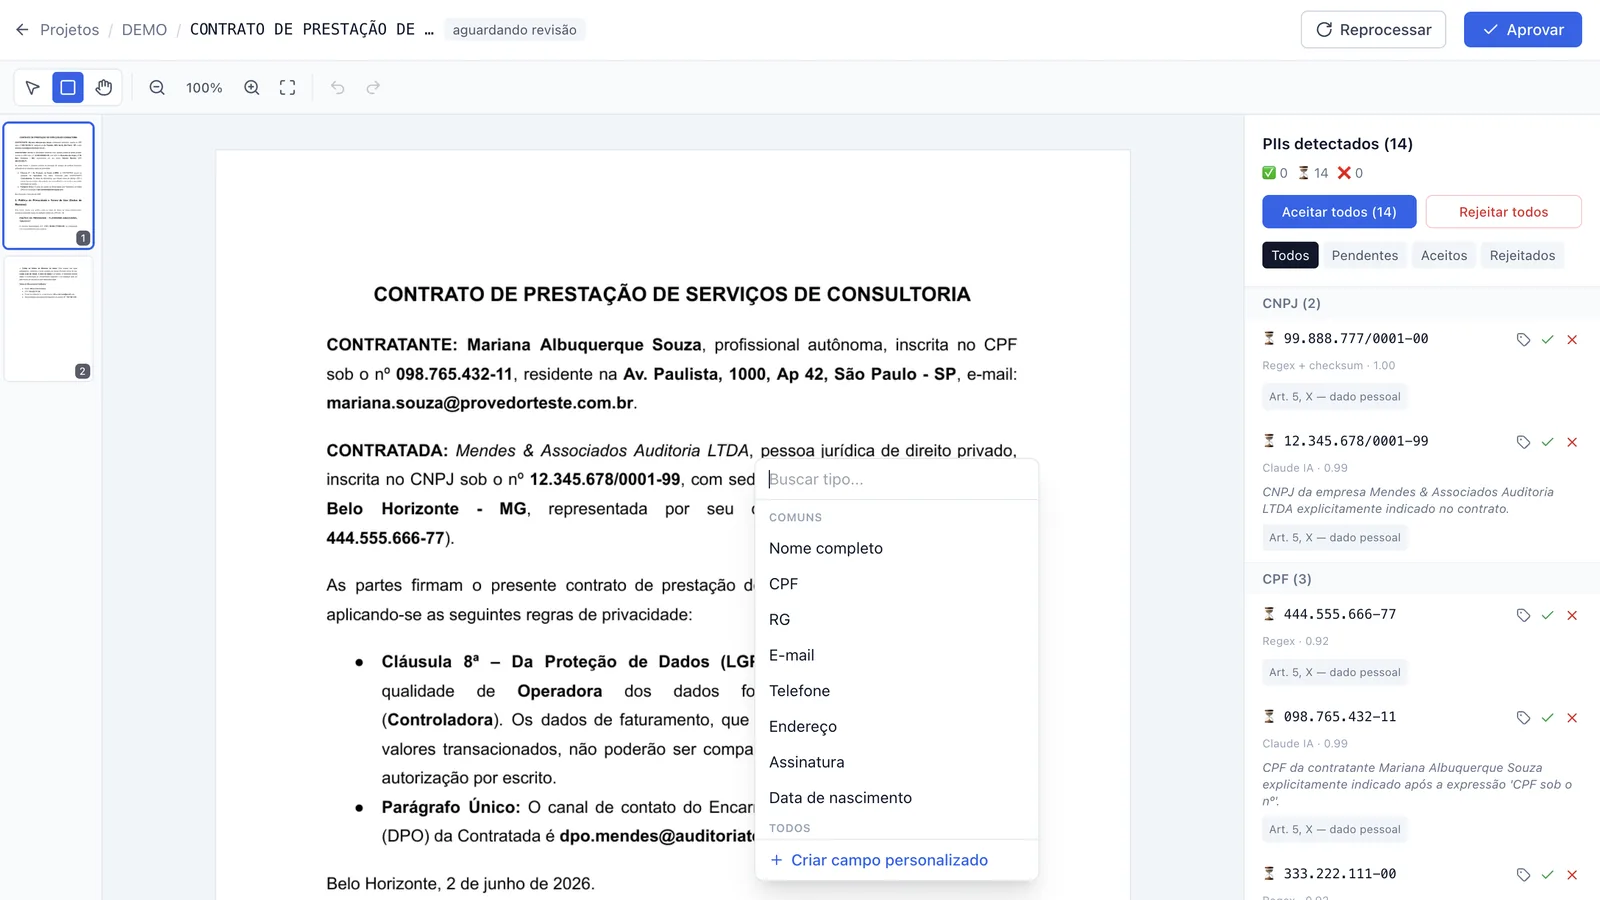
A interface de revisão apresentada no material aproxima duas informações que precisam ser analisadas juntas: o documento, à esquerda, e a lista de possíveis dados pessoais, à direita. O revisor compara cada ocorrência com seu contexto e pode aceitar, rejeitar ou corrigir a proposta do sistema.
Essa organização evita que a decisão seja tomada apenas sobre uma lista de palavras desconectadas. Um mesmo termo pode ser sobrenome, parte de um endereço ou nome de uma empresa. O trecho em que aparece ajuda a definir o tratamento adequado.
O que as regras determinísticas resolvem
A implementação prioriza verificações programadas antes de recorrer ao modelo de IA. CPFs e CNPJs permitem combinar reconhecimento de formato com validação de dígitos verificadores. Outros campos, como CEPs, podem ser localizados por padrões próprios, sem que isso equivalha à mesma validação matemática dos identificadores anteriores.
A vantagem é operacional. Uma regra conhecida pode ser executada de forma previsível, inspecionada pela equipe e aplicada sem consumir tokens de um modelo. O fluxo não precisa pedir à IA que evite trabalho desnecessário: a aplicação decide previamente quando uma chamada é necessária.
Essa previsibilidade tem limites. Validar um dígito verificador não comprova a existência de um cadastro, a identidade de seu titular ou a necessidade jurídica de remover aquele número. A regra resolve uma pergunta técnica delimitada; a decisão sobre o documento depende de outras informações.
Onde a inteligência artificial acrescenta capacidad
Nomes, endereços por extenso e informações sensíveis inseridas em parágrafos não apresentam sempre uma estrutura regular. Nesses casos, a IA pode reconhecer relações que uma expressão regular isolada não alcança.
O material mostra ocorrências acompanhadas de origem, pontuação de confiança e justificativa. Um achado aparece associado a regra determinística; outro, ao modelo, com uma explicação que o revisor pode confrontar com o contrato.
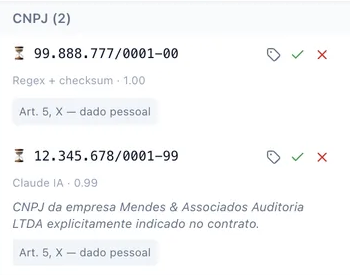
Uma pontuação de 1,00 atribuída a uma regra e outra de 0,99 atribuída ao modelo não devem ser interpretadas automaticamente como probabilidades comparáveis. Sem conhecer sua definição e calibração, esses valores são sinais operacionais para apoiar a revisão, não garantias de acerto.
O CNPJ também merece atenção: a LGPD protege dados relacionados a pessoas naturais. Um identificador de pessoa jurídica não se torna dado pessoal apenas por aparecer em um contrato. Pode haver relação com uma pessoa identificável ou outra razão para restringir sua divulgação, mas essa análise precisa considerar o contexto.
Classificação do dado e base legal precisam ser registradas separadamente
As telas reproduzidas utilizam a etiqueta “Art. 5, X” junto a ocorrências classificadas como dado pessoal. Esse inciso define tratamento, e não uma hipótese que o autorize. A identificação da base legal exige examinar as hipóteses aplicáveis, como as dos artigos 7º e 11 da LGPD.
Na prática, o registro pode distinguir o tipo de informação, o motivo da restrição, a finalidade da operação e a base legal validada pela organização. Essa separação torna a decisão mais compreensível e evita que um rótulo de interface seja tomado como demonstração suficiente de conformidade.
Rostos, assinaturas e carimbos exigem detecção visual
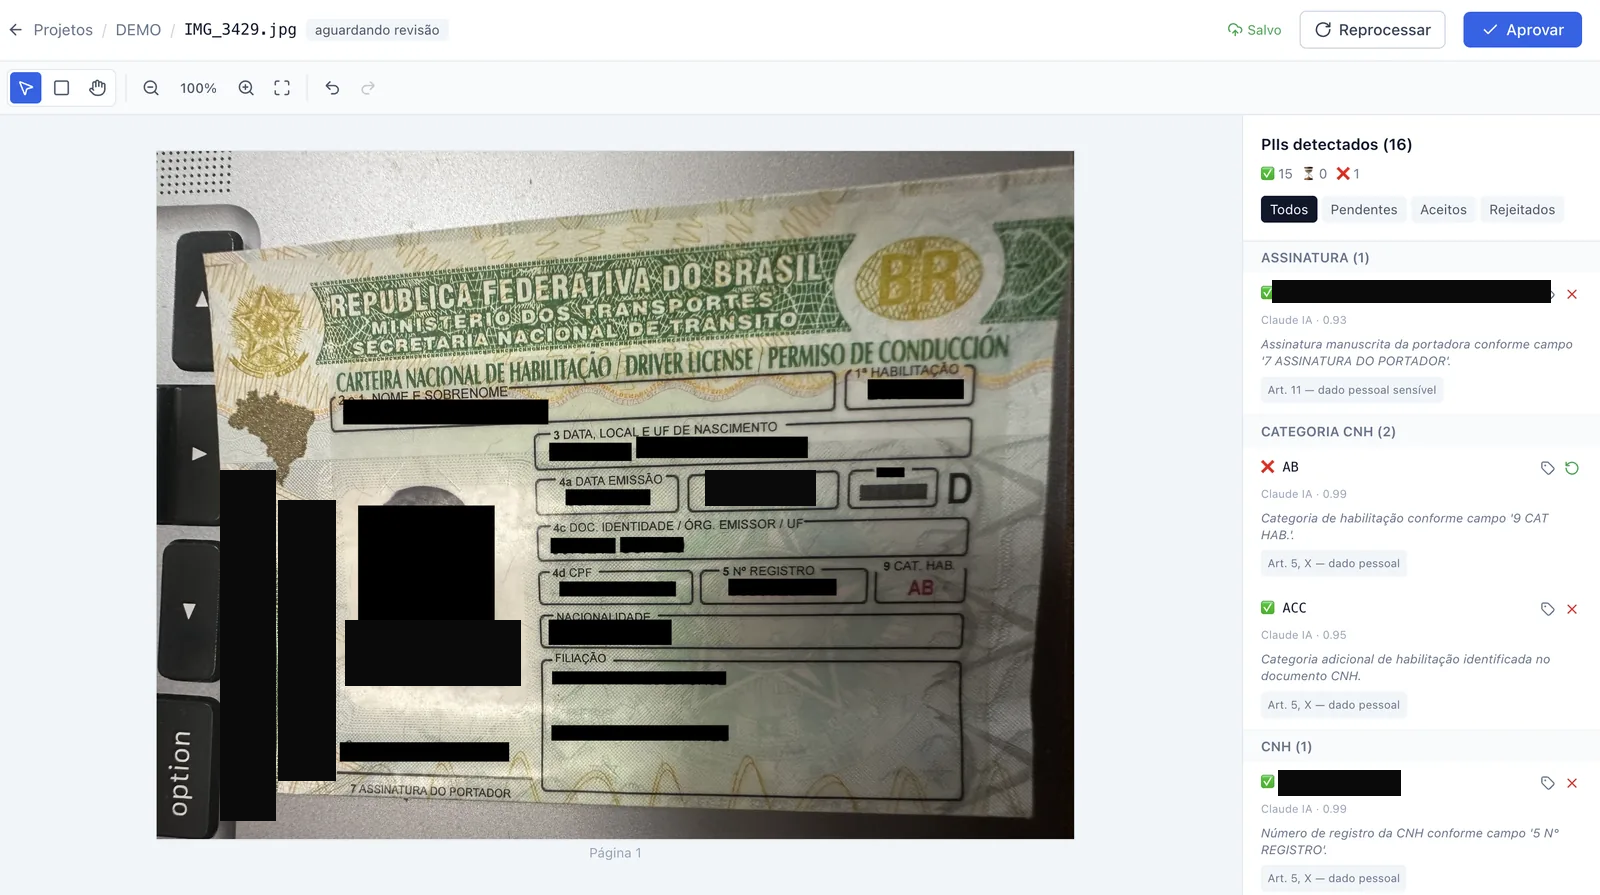
O OCR reconhece caracteres. Essa capacidade não basta para localizar todos os elementos que merecem proteção em um documento. Uma fotografia de rosto, uma assinatura manuscrita ou um carimbo com informações identificadoras podem exigir análise da imagem, além da leitura de texto.
O exemplo de documento fotografado apresentado no PDF mostra essa combinação. A solução trata campos textuais e áreas visuais na mesma página. A fonte informa que recebeu tarjas adicionais antes da publicação, preservadas na reprodução abaixo.
Detectar um elemento visual não é o mesmo que classificá-lo juridicamente
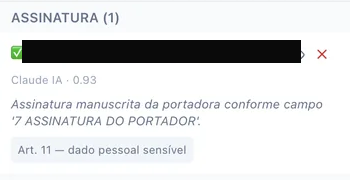
Uma assinatura pode identificar uma pessoa e requer atenção no compartilhamento documental. Seu enquadramento como dado biométrico sensível, porém, depende das características e do contexto do tratamento. A decisão não deve ser deduzida apenas do formato visual da ocorrência.
O GDPR explicita que fotografias não constituem automaticamente tratamento de categorias especiais: o enquadramento biométrico está relacionado ao processamento técnico voltado à identificação ou autenticação únicas. 3
Na solução descrita, a assinatura recebe tratamento reforçado no motor de sinais. Esse é o comportamento demonstrado pela interface, que deve ser acompanhado de uma classificação jurídica adequada ao uso concreto.
Duas tecnologias e um custo visível
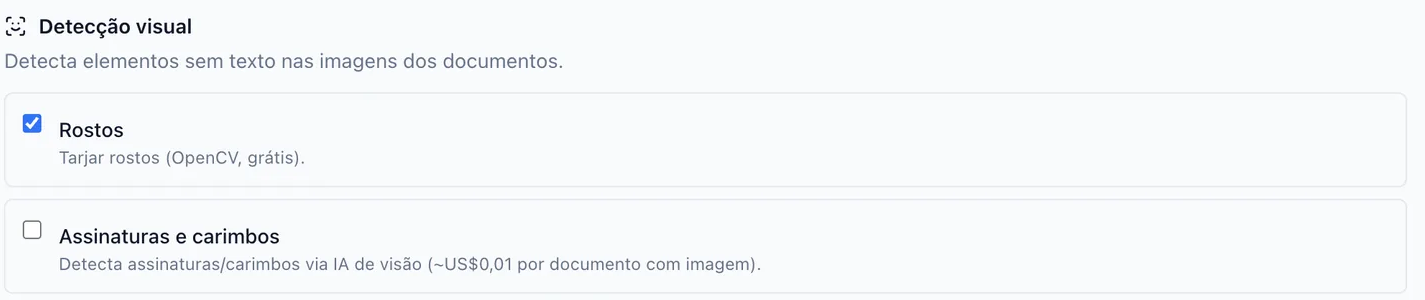
O motor de sinais separa a detecção de rostos da análise de assinaturas e carimbos. Segundo o autor, os rostos são localizados por um classificador executado em CPU, habilitado por padrão. Não há cobrança de API nessa etapa, embora existam os custos de infraestrutura da aplicação.
Assinaturas e carimbos utilizam um modelo de visão, acionado quando necessário. A dificuldade inclui distinguir uma rubrica de um logotipo, um brasão ou uma marca na digitalização. A interface apresenta uma estimativa de aproximadamente US$ 0,01 por documento com imagem para essa funcionalidade.
Esse valor pertence ao exemplo de implementação. Não representa o custo total da operação nem uma tarifa universal: quantidade de páginas, qualidade das imagens, modelo utilizado e necessidade de reprocessamento podem alterar o consumo.
A revisão humana transforma uma sugestão em decisão registrada
A detecção oferece candidatos à remoção. A revisão determina o que será efetivamente tratado. Essa diferença aparece no exemplo com 15 ocorrências aceitas e uma rejeitada.
A rejeição tem valor documental: demonstra que o sistema apresentou uma hipótese, que alguém a avaliou e que a decisão foi diferente da sugestão automática. Uma ferramenta que permite discordância preserva a utilidade do conteúdo e oferece condições para corrigir excessos de detecção.
Para que a revisão seja verificável, o histórico precisa relacionar a ação ao documento, à ocorrência, à versão e ao responsável. Um contador na tela ajuda a acompanhar o trabalho, mas não substitui esse histórico.
Também é necessário registrar correções. O revisor pode alterar a categoria, ajustar uma região ou desenhar manualmente uma tarja quando o sistema não localiza o elemento. A intervenção humana, nesse desenho, participa da produção do resultado e da melhoria do processamento seguinte.
A revisão obrigatória é uma escolha da arquitetura apresentada. Seu valor está em definir um ponto de decisão e produzir evidência sobre ele. A qualidade dessa etapa continua dependendo de contexto suficiente, treinamento dos revisores e condições reais para examinar as ocorrências.
A anonimização precisa fazer parte do fluxo documental
Em uma operação contínua, os documentos chegam por diferentes caminhos: inclusão manual, integração, recebimento de um lote ou evento de outro sistema. Se a proteção depender de uma ação avulsa ao final do processo, torna-se mais difícil garantir que cada documento passou pelo mesmo controle.
O protótipo de workflow apresentado na fonte insere a anonimização entre a entrada do documento e seu encaminhamento. O catálogo reúne gatilhos por caso, documento, webhook e execução manual; ações de anonimizar, executar agentes, extrair dados, buscar documentos e enviar informações; além de condições e transformações.
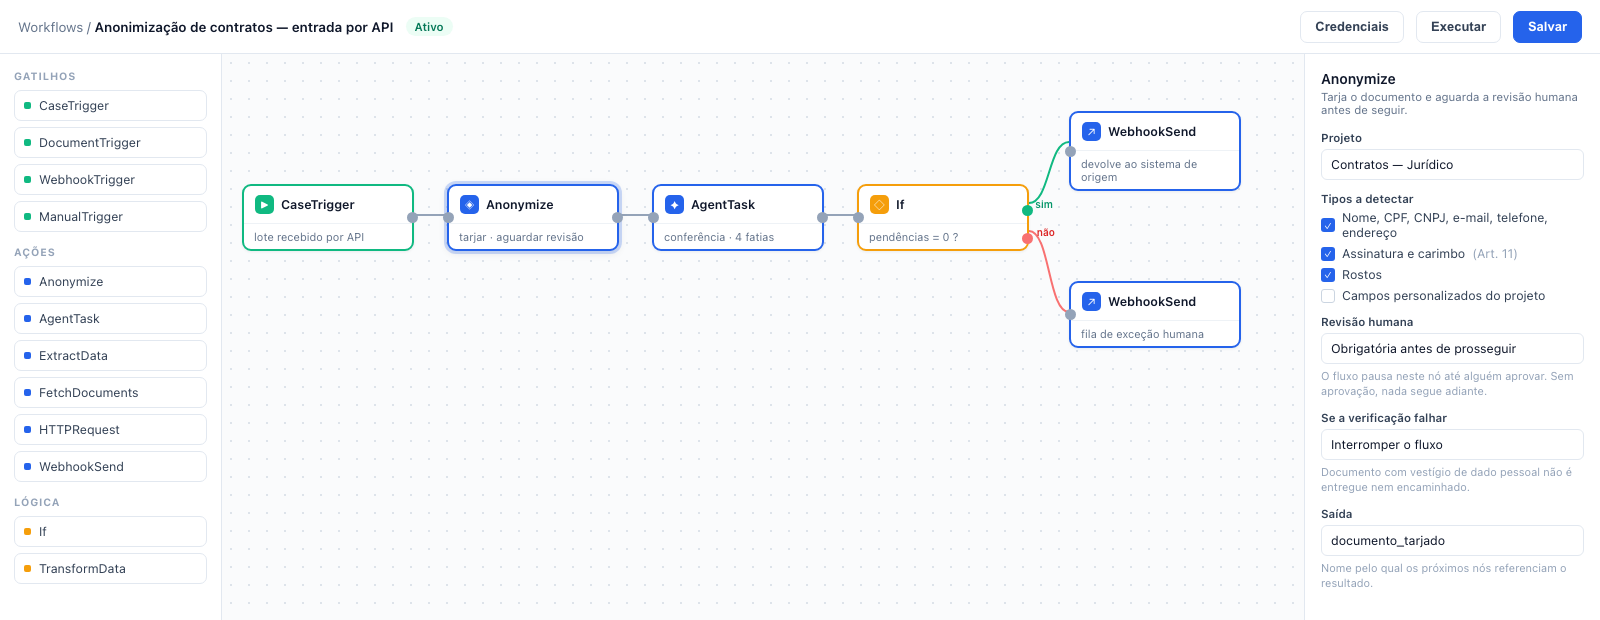
Três comportamentos sustentam esse desenho. O primeiro é a pausa: o documento aguarda a aprovação prevista antes de continuar. O segundo é a interrupção diante de falha na verificação. O terceiro é a existência de um caminho próprio para pendências que exigem intervenção.
Uma exceção, portanto, não precisa desaparecer em uma fila genérica nem ser liberada silenciosamente. Ela recebe um destino definido. Isso permite tratar a dificuldade sem perder de vista o documento e a razão pela qual o processamento foi interrompido.
O material também propõe que a área de negócio organize o fluxo com os componentes existentes. Essa autonomia depende de regras claras para alteração e aprovação das configurações: mudar uma condição de encaminhamento pode afetar quais documentos serão entregues e em que momento.
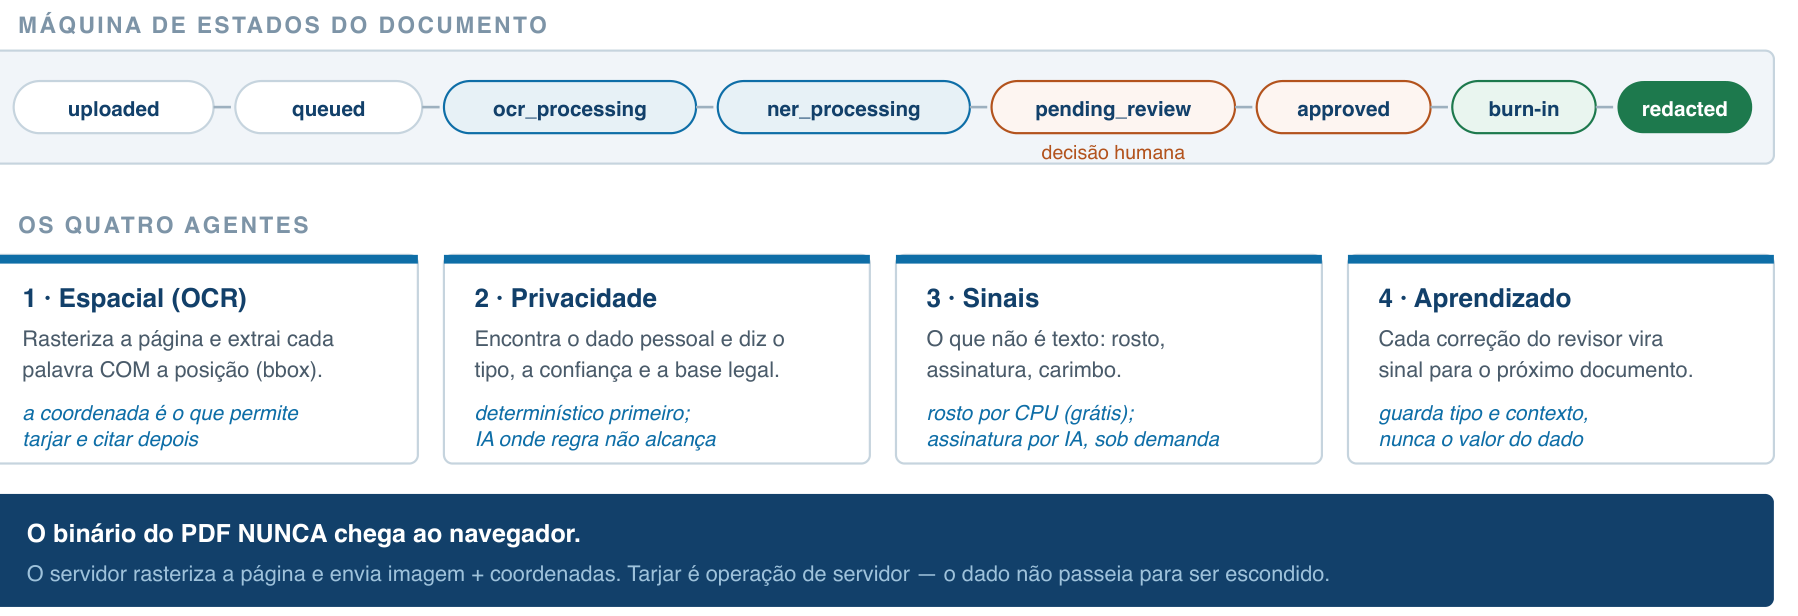
Quatro agentes e oito estados organizam o processamento
A arquitetura divide o trabalho em quatro agentes especializados. Essa divisão torna visível a responsabilidade de cada etapa e ajuda a localizar a origem de um resultado inadequado.
O agente espacial mantém o vínculo entre palavra e posição
O agente de OCR transforma a página em uma representação visual e identifica palavras com suas caixas de delimitação, as bounding boxes. A informação espacial permite relacionar o texto reconhecido à área que será examinada e, se aprovada, removida.
Guardar apenas uma sequência de palavras seria insuficiente para esse trabalho. O sistema precisa saber onde cada ocorrência aparece, inclusive quando um nome se repete ou atravessa uma quebra de linha. As coordenadas também ajudam a manter a referência à página na recuperação posterior.
Privacidade, sinais e aprendizado têm funções distintas
O agente de privacidade procura dados no conteúdo textual, aplicando primeiro as regras e depois a IA nos casos que exigem interpretação. O agente de sinais procura elementos visuais. O agente de aprendizado utiliza as intervenções dos revisores para orientar as próximas análises.
Separar essas funções evita tratar falhas diferentes como se fossem o mesmo problema. Uma palavra ilegível exige uma ação sobre a leitura. Uma palavra corretamente extraída, mas classificada de modo incorreto, exige revisão da detecção. Uma assinatura não localizada exige análise da capacidade visual.
Os estados tornam a passagem de etapa explícita
O documento percorre oito estados no esquema da fonte: uploaded, queued, ocrprocessing, nerprocessing, pending_review, approved, burn-in e redacted. Em termos operacionais, eles representam recebimento, fila, leitura, reconhecimento de entidades, revisão, aprovação, aplicação das remoções e conclusão.
A passagem por approved antes de burn-in posiciona a decisão humana antes da transformação final. O estado de conclusão precisa refletir a verificação do arquivo produzido, e não apenas o término de uma tarefa de processamento.
Outra decisão relatada é manter o PDF original no servidor e enviar ao navegador imagens e coordenadas para revisão. Isso evita entregar o binário original nessa etapa, mas não significa ausência de dados pessoais no navegador: a própria imagem exibida ao revisor pode contê-los. Autorização, sessão e controle de acesso continuam relevantes.
Burn-in: remover o conteúdo e conferir o arquivo produzido
O termo burn-in é utilizado no material para a aplicação efetiva das remoções no PDF. O resultado pretendido é uma versão em que o texto ou os pixels selecionados deixem de fazer parte do conteúdo recuperável.
A fonte apresenta duas chamadas que ilustram a sequência entre definir a área e aplicar a redação:
page.add_redact_annot(rect, fill=(0, 0, 0))
page.apply_redactions(images=_IMG_REDACT_MODE)
O trecho é ilustrativo, não um procedimento completo. A documentação do PyMuPDF relaciona a remoção física ao salvamento com opções adequadas de descarte de objetos e descreve comportamentos específicos para texto e imagens. A configuração, a gravação do arquivo e a validação da saída fazem parte da implementação.
Um nome pode aparecer mais de uma vez
O autor relata um problema encontrado em produção: em contratos com o mesmo nome repetido, a caixa detectada cobria uma ocorrência enquanto outras permaneciam. A resposta descrita foi refinar a localização dos caracteres e de suas posições.
Esse exemplo revela uma diferença entre reconhecer um valor e eliminar todas as ocorrências que devem ser protegidas. Encontrar um nome uma vez não demonstra que ele foi tratado no cabeçalho, no corpo e na assinatura do contrato.
O processamento também precisa lidar com variações de caixa, pontuação e quebra de linha. A correspondência entre o texto reconhecido e os glifos da página ajuda a cobrir esses casos, sempre com verificação do resultado.
A falha de verificação deve impedir a entrega
Na implementação relatada, o arquivo é reaberto depois da transformação. Se forem encontrados vestígios das informações que deveriam ter sido removidas, a entrega é bloqueada. Se o sistema não conseguir reabrir o arquivo para verificar, também interrompe o fluxo.
Esse comportamento é conhecido como falhar fechado: a ausência de confirmação não é interpretada como sucesso. O registro do problema preserva o tipo ou a forma da ocorrência, evitando reproduzir o próprio valor pessoal no log.
A verificação descrita é uma barreira contra remoções incompletas. Ela não comprova, sozinha, que a detecção inicial encontrou todos os dados relevantes nem que desapareceu o risco de identificação indireta. Essas são perguntas diferentes, que precisam permanecer no processo de revisão.
Pedir o PDF de saída e tentar copiar o texto sob a tarja é um bom teste inicial para identificar ocultações superficiais. Uma avaliação técnica deve examinar também a extração de texto e os demais conteúdos do arquivo. A incapacidade de copiar uma palavra não prova, isoladamente, que todas as formas de recuperação foram eliminadas.
O custo por documento afeta a capacidade de aplicar o controle
Uma solução pode apresentar bons resultados em um lote pequeno e se tornar difícil de sustentar quando o volume cresce. Se cada operação enviar documentos completos a um modelo, o custo se repete mesmo quando a informação necessária já foi extraída ou poderia ser reconhecida por uma regra.
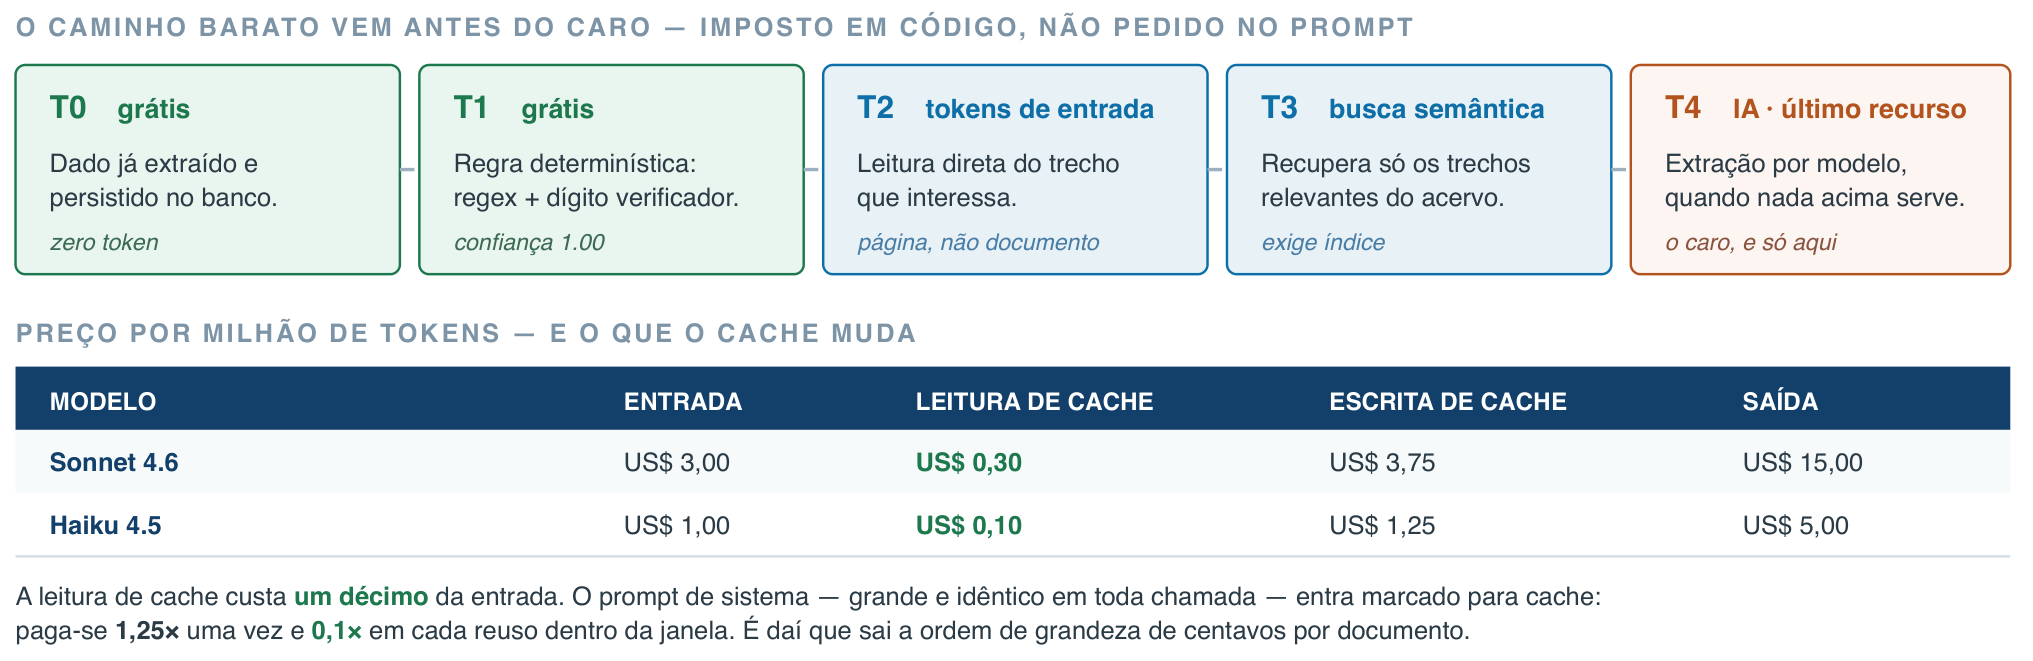
O material organiza a economia de processamento em cinco níveis. A sequência começa no reaproveitamento autorizado de dados já disponíveis, passa por regras e consultas delimitadas e reserva a extração por modelo para situações que as etapas anteriores não resolveram.
O reaproveitamento de T0 também precisa respeitar a política de acesso e retenção. Evitar uma chamada não justifica conservar dados pessoais indefinidamente. A economia deve acontecer dentro das condições definidas para o acervo.
Como o cache reduz chamadas repetidas
O prompt de sistema contém instruções que podem se repetir entre documentos. Quando o provedor permite reutilizar esse prefixo por cache, parte do conteúdo deixa de ser cobrada como entrada nova a cada chamada elegível.
Os preços apresentados no PDF correspondem à seguinte comparação, em dólares por milhão de tokens:
| MODELO | ENTRADA | LEITURA DE CACHE | ESCRITA DE CACHE | SAÍDA |
|---|---|---|---|---|
| Sonnet 4.6 | US$ 3,00 | US$ 0,30 | US$ 3,75 | US$ 15,00 |
| Haiku 4.5 | US$ 1,00 | US$ 0,10 | US$ 1,25 | US$ 5,00 |
Nessa modalidade, a escrita equivale a 1,25 vez a entrada e a leitura a 0,1 vez. A tabela oficial diferencia a duração do cache; os multiplicadores não devem ser generalizados para toda configuração. Esses valores foram conferidos em 26 de setembro de 2026 e podem mudar. 6
O benefício depende do reuso efetivo dentro da janela aplicável. O total por documento ainda inclui conteúdo novo, saída do modelo, OCR, visão quando habilitada, armazenamento, infraestrutura e revisão. A afirmação de custo na ordem de centavos, presente na fonte, deve ser entendida no contexto dessa arquitetura e de sua carga de trabalho.
A relação com a governança é direta: um controle economicamente viável tem mais condições de acompanhar o volume do acervo. Isso não significa que amostragem seja sempre inadequada; ela pode apoiar avaliação de qualidade. O problema ocorre quando documentos que exigem tratamento individual são liberados sem ele apenas para reduzir custo.
Configurações por projeto aproximam o sistema do acervo real
Documentos de áreas diferentes apresentam vocabulários, campos e problemas de leitura distintos. Uma configuração única tende a ignorar particularidades importantes ou a produzir remoções excessivas.
A tela de projeto apresentada no material reúne detecção visual, aprendizado, campos personalizados e correção de OCR. Essas opções permitem ajustar a operação ao conjunto documental que será processado.
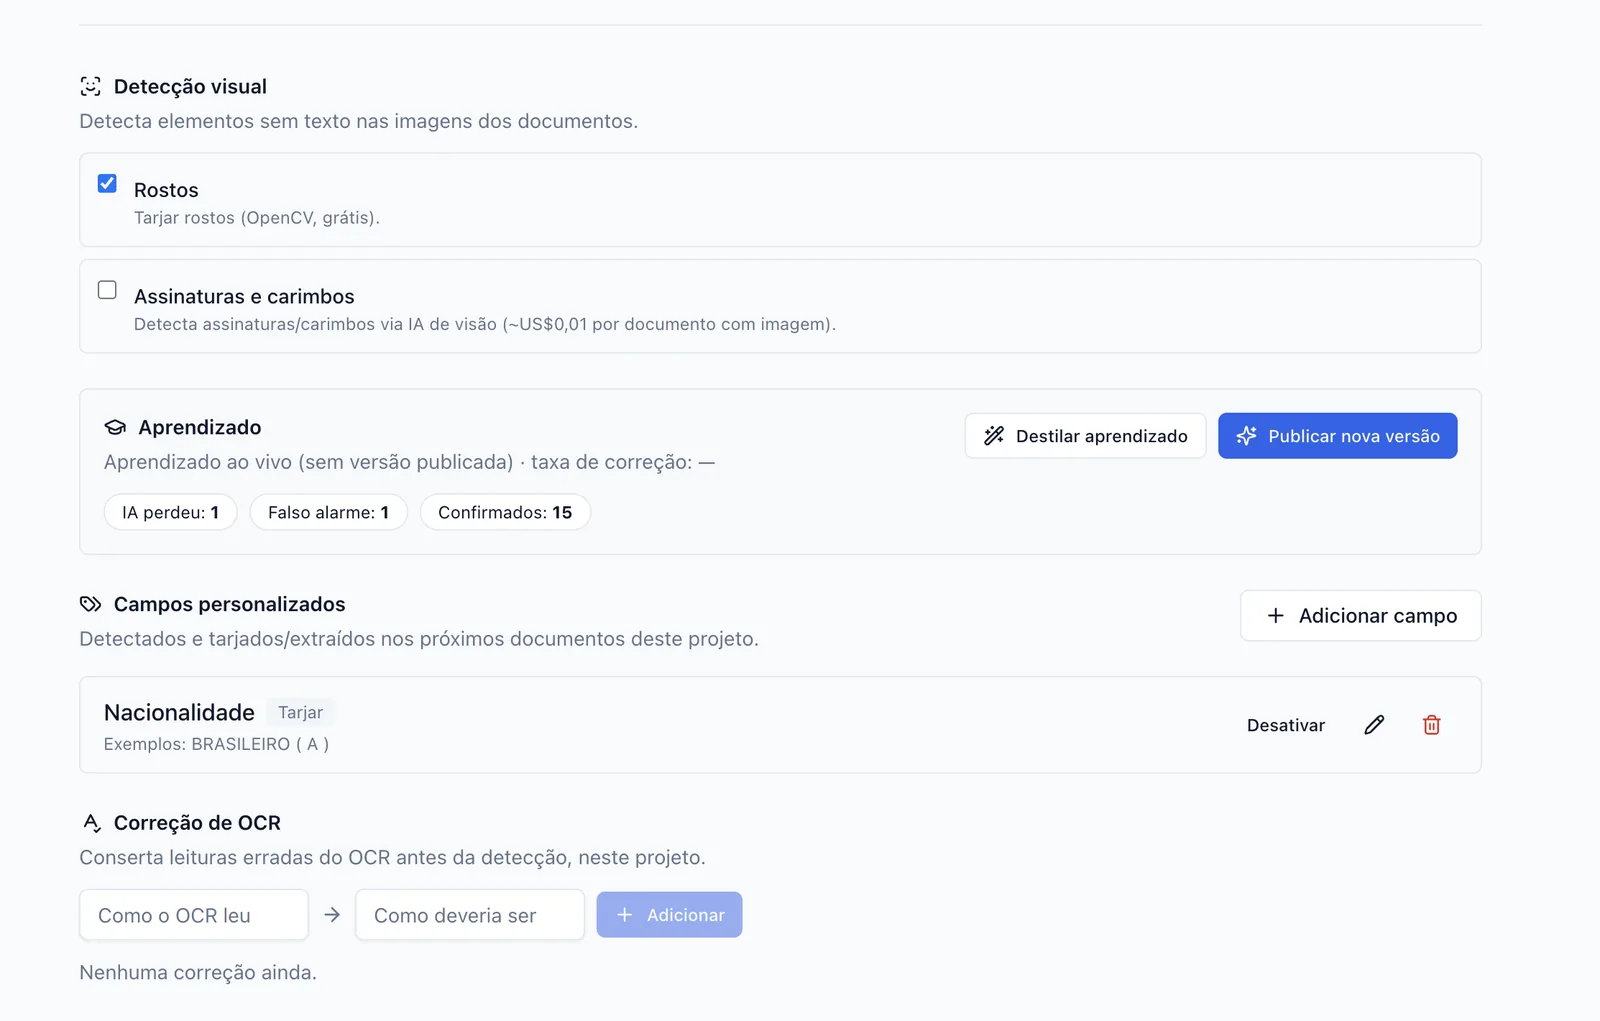
Nos campos personalizados, a organização define informações que merecem tratamento naquele contexto. A demonstração utiliza nacionalidade, mas sua presença na interface não estabelece uma obrigação geral de suprimir esse campo. A finalidade do acesso e o risco de identificação orientam a configuração.
A correção de OCR atua antes da detecção. Ela permite registrar como uma expressão foi lida e qual deveria ser sua forma correta. Assim, um erro recorrente de reconhecimento pode ser tratado no projeto, em vez de reaparecer em cada documento sem uma resposta organizada.
Esses mecanismos não recuperam informação que uma imagem de baixa qualidade tornou ilegível. Eles ajudam a administrar erros conhecidos e reforçam a necessidade de acompanhar a qualidade dos documentos recebidos.
Aprender com as correções sem criar outra coleção de dados pessoais
As decisões dos revisores contêm informação útil sobre o desempenho do sistema. Uma ocorrência acrescentada manualmente mostra algo que a detecção perdeu. Uma rejeição pode indicar excesso. Uma confirmação reforça um comportamento considerado adequado naquele contexto.
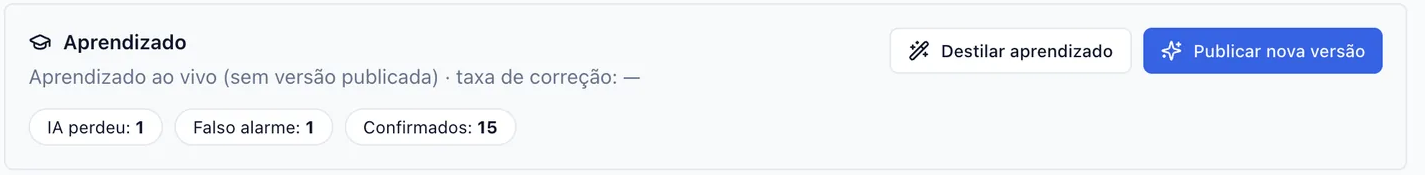
O painel de aprendizado separa essas situações em três contadores: “IA perdeu”, “Falso alarme” e “Confirmados”. Eles correspondem, respectivamente, às omissões percebidas na revisão, aos excessos identificados e aos achados validados.
O valor removido não precisa virar exemplo permanente
Guardar o CPF que o modelo deixou passar poderia melhorar um exemplo de treinamento e, ao mesmo tempo, criar uma nova cópia do dado que se pretendia proteger. O sistema descrito procura evitar essa contradição: registra tipo e contexto, mantendo nulo o campo destinado ao valor pessoal.
O princípio de necessidade da LGPD limita o tratamento ao que é pertinente para sua finalidade. 2 Aplicado ao aprendizado, ele leva a uma pergunta prática: qual informação é necessária para corrigir o comportamento, sem reproduzir desnecessariamente o conteúdo individual?
Também é preciso avaliar o contexto conservado. Zerar um campo não anonimiza automaticamente as palavras ao redor. Se o trecho descrever uma pessoa de modo singular, ainda pode haver identificação indireta. O aprendizado deve ser submetido ao mesmo cuidado que motivou o tratamento do documento.
Destilação de regras é diferente de ajuste dos pesos do modelo
O autor caracteriza sua abordagem como aprendizado em contexto, com destilação de regras e participação humana. As correções orientam instruções utilizadas nas análises seguintes; não se trata, nesse desenho, de atualizar os pesos do modelo com cada documento.
Uma regra escrita pode ser lida, discutida, aprovada e retirada. O versionamento permite relacionar uma análise à configuração vigente e retornar a uma versão anterior quando uma mudança produzir resultados inadequados.
A interface distingue “Destilar aprendizado” de “Publicar nova versão”. Essa separação cria espaço para avaliar o que será incorporado antes de consolidar seu uso. A melhoria deixa de depender de uma promessa abstrata de que o sistema aprenderá sozinho e passa a produzir um objeto que a equipe pode examinar.
Isso não significa que todo modelo ajustado seja impossível de avaliar. Significa que, na implementação apresentada, a organização escolheu uma forma de adaptação que favorece inspeção e reversão explícitas das regras.
A proteção precisa continuar quando o documento entra na busca A proteção precisa continuar quando o documento entra na busca
Depois de tratar os documentos, a organização quer consultá-los. A busca semântica permite recuperar trechos por proximidade de significado e montar respostas com apoio no acervo. Surge, porém, uma pergunta: qual versão do conteúdo alimenta essa busca?
Se o arquivo disponibilizado está tarjado, mas o índice foi produzido a partir do texto original, o ambiente mantém outra representação das informações removidas. A resposta pode voltar a expor nomes, números ou fragmentos que deixaram de aparecer no PDF de acesso.
O risco envolve os trechos textuais armazenados, os metadados e as representações vetoriais. Um vetor não deve ser tratado como uma cópia literal de cada dado, mas a vetorização também não comprova anonimização. A decisão de proteção precisa acontecer antes da indexação e considerar todos os componentes da busca.
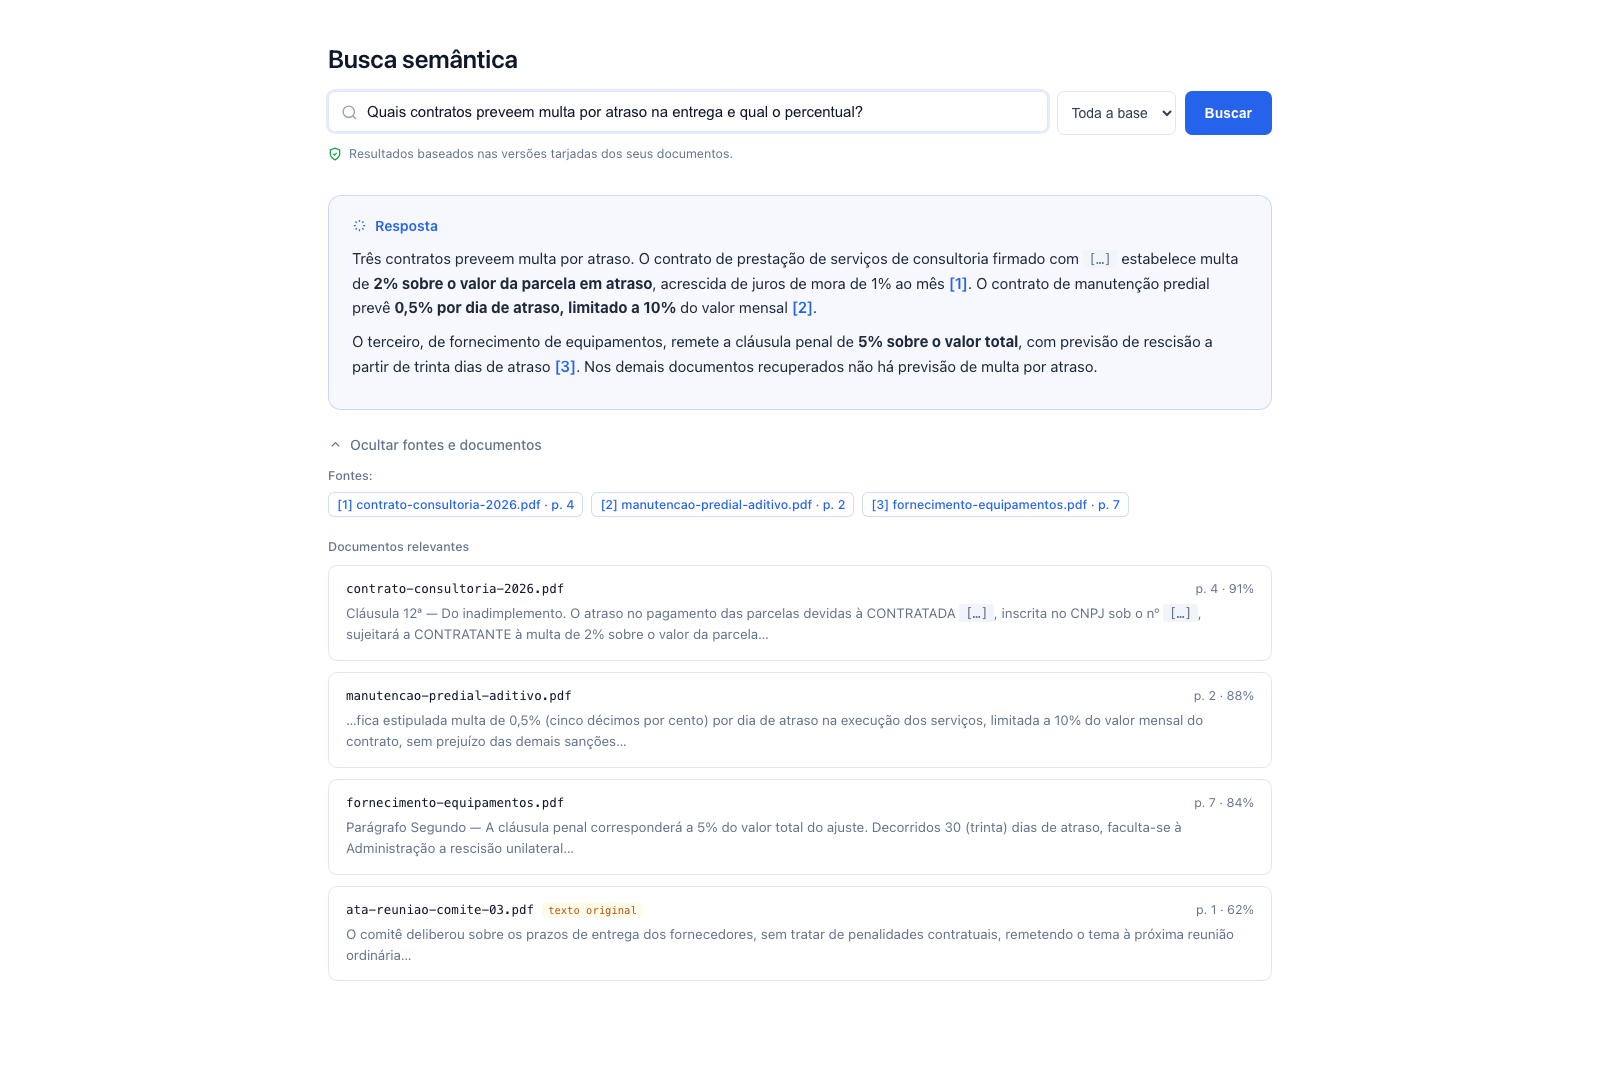
O exemplo pergunta quais contratos preveem multa por atraso e qual é o percentual. A resposta reúne condições diferentes, mantém máscaras nos pontos protegidos e indica arquivos e páginas. Os percentuais exibidos pertencem aos documentos de demonstração; sua função é mostrar como a informação contratual pode ser consultada sem reproduzir todos os identificadores.
A interface também apresenta um resultado de menor similaridade que não trata diretamente da penalidade. Tornar esse limite visível ajuda a distinguir o que sustenta a resposta do que apenas se aproximou da consulta.
O selo sobre uso de versões tarjadas precisa corresponder ao conteúdo real do índice. A presença de um item identificado como “texto original”, na própria demonstração, mostra por que um aviso genérico não basta. Em uma operação desse tipo, a sinalização deve refletir as exceções e o escopo autorizado para a consulta.
Duas máscaras conectam a tarja ao índice semântico
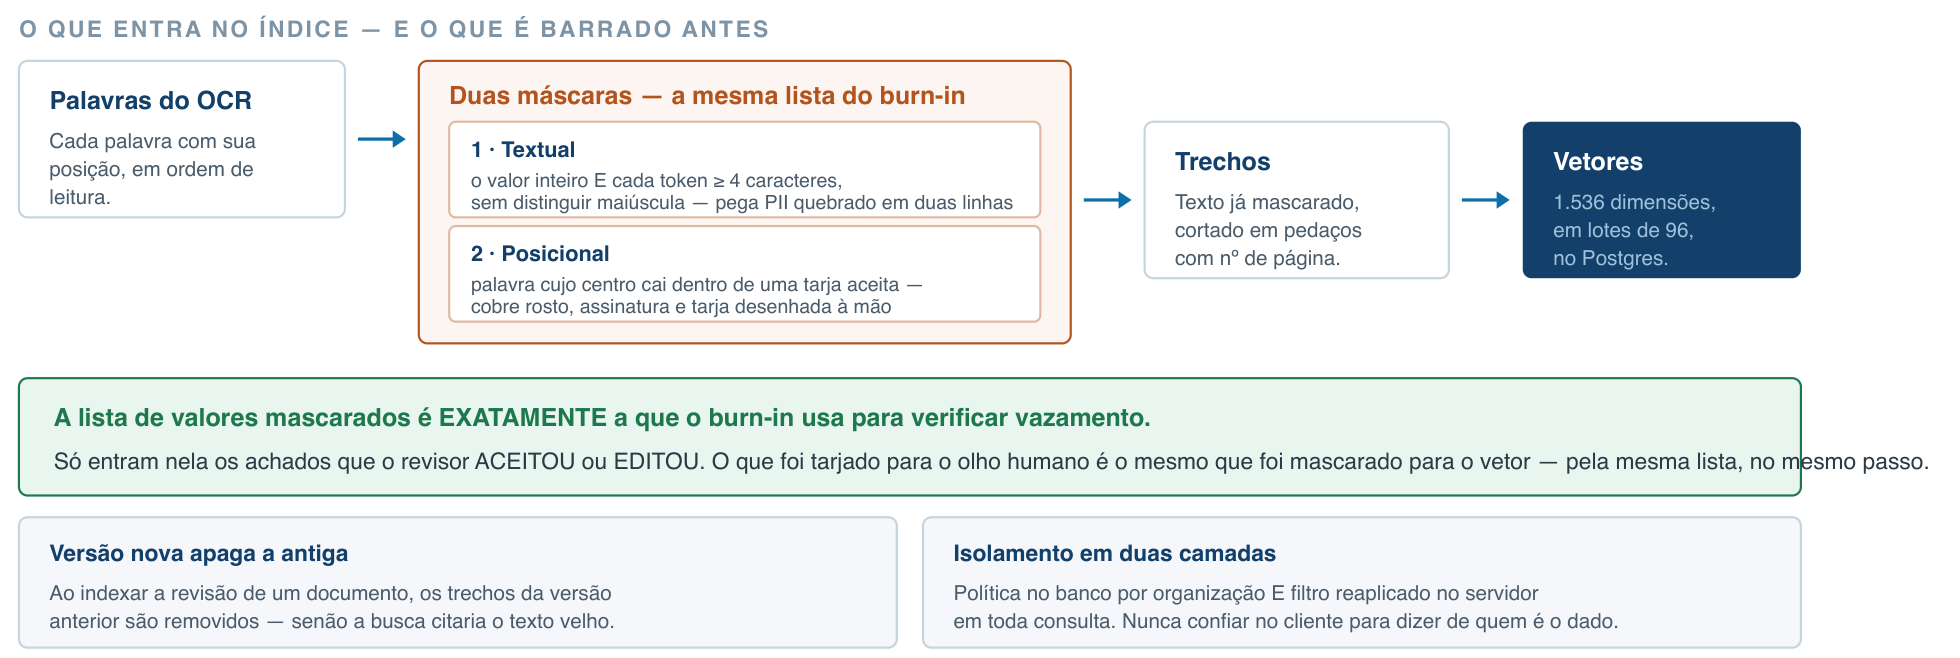
A arquitetura procura manter a mesma decisão de proteção no PDF e na busca. Para isso, utiliza a lista de ocorrências aceitas ou editadas pelo revisor na remoção, na verificação e no preparo do texto a ser indexado.
Ocorrências rejeitadas não entram nessa lista. Trata-se de respeitar a decisão de revisão: se um termo foi considerado legítimo naquele contexto, apagá-lo do índice reduziria a qualidade da pesquisa. A rejeição, entretanto, continua sendo uma decisão passível de erro e deve permanecer rastreável.
A máscara textual procura o valor e seus componentes
O mecanismo relatado substitui o valor completo e seus tokens com quatro ou mais caracteres. A busca ignora a diferença entre maiúsculas e minúsculas e aplica as substituições dos termos maiores para os menores.
Essa estratégia procura cobrir situações em que o dado aparece parcialmente. Um nome dividido em duas linhas pode não ser encontrado como uma única expressão, enquanto o sobrenome permanece reconhecível. Tratar os componentes reduz a dependência de uma correspondência exata com o valor completo.
O limite de quatro caracteres é uma escolha da implementação, não um critério jurídico. Nomes curtos, variações de OCR e palavras compartilhadas com conteúdos legítimos continuam exigindo avaliação. Remover componentes de modo muito amplo também pode prejudicar a compreensão do documento.
A máscara posicional acompanha a área aprovada
A segunda máscara usa as coordenadas das palavras. Se o centro de uma palavra reconhecida estiver dentro de uma região aprovada para remoção, ela não segue para o índice.
Isso complementa a correspondência textual, sobretudo nas áreas desenhadas manualmente e nas regiões de assinatura, rosto ou carimbo em que o OCR possa ter extraído caracteres. O texto associado à região acompanha a decisão visual de proteção.
As duas estratégias resolvem problemas diferentes. A textual procura ocorrências pela forma do conteúdo; a posicional procura palavras pela localização. Seu uso conjunto amplia a cobertura, sem eliminar a necessidade de conferir se as regiões e os valores escolhidos estão corretos.
A atualização precisa retirar a versão anterior
Depois das máscaras, o texto é dividido em trechos com referência de página. Na implementação descrita, os vetores têm 1.536 dimensões, são gerados em lotes de 96 e armazenados em PostgreSQL. Esses números caracterizam a solução apresentada; não são requisitos gerais de anonimização.
Quando uma revisão é indexada, os trechos anteriores daquele documento são removidos. Sem esse passo, a busca poderia continuar recuperando uma versão antiga, inclusive com informações já retiradas da versão atual.
O desenho também combina isolamento no banco por organização e filtro reaplicado no servidor. A consulta precisa obter seu escopo a partir da identidade autorizada, sem depender apenas de um identificador enviado pela interface. A qualidade da resposta não tem utilidade se o usuário recebe conteúdo de um acervo ao qual não deveria ter acesso.
Recuperar os trechos mais parecidos pode deixar documentos importantes de fora
A qualidade da busca depende da seleção do contexto. O material apresenta uma pergunta que evidencia o problema: quem participou de mais reuniões em um conjunto de 50 atas?
Uma recuperação global dos oito trechos mais similares pode escolher passagens de apenas duas atas, especialmente se forem mais extensas ou repetirem mais vezes os termos da consulta. O modelo recebe um contexto aparentemente relevante, mas sem representação das outras 48 reuniões.
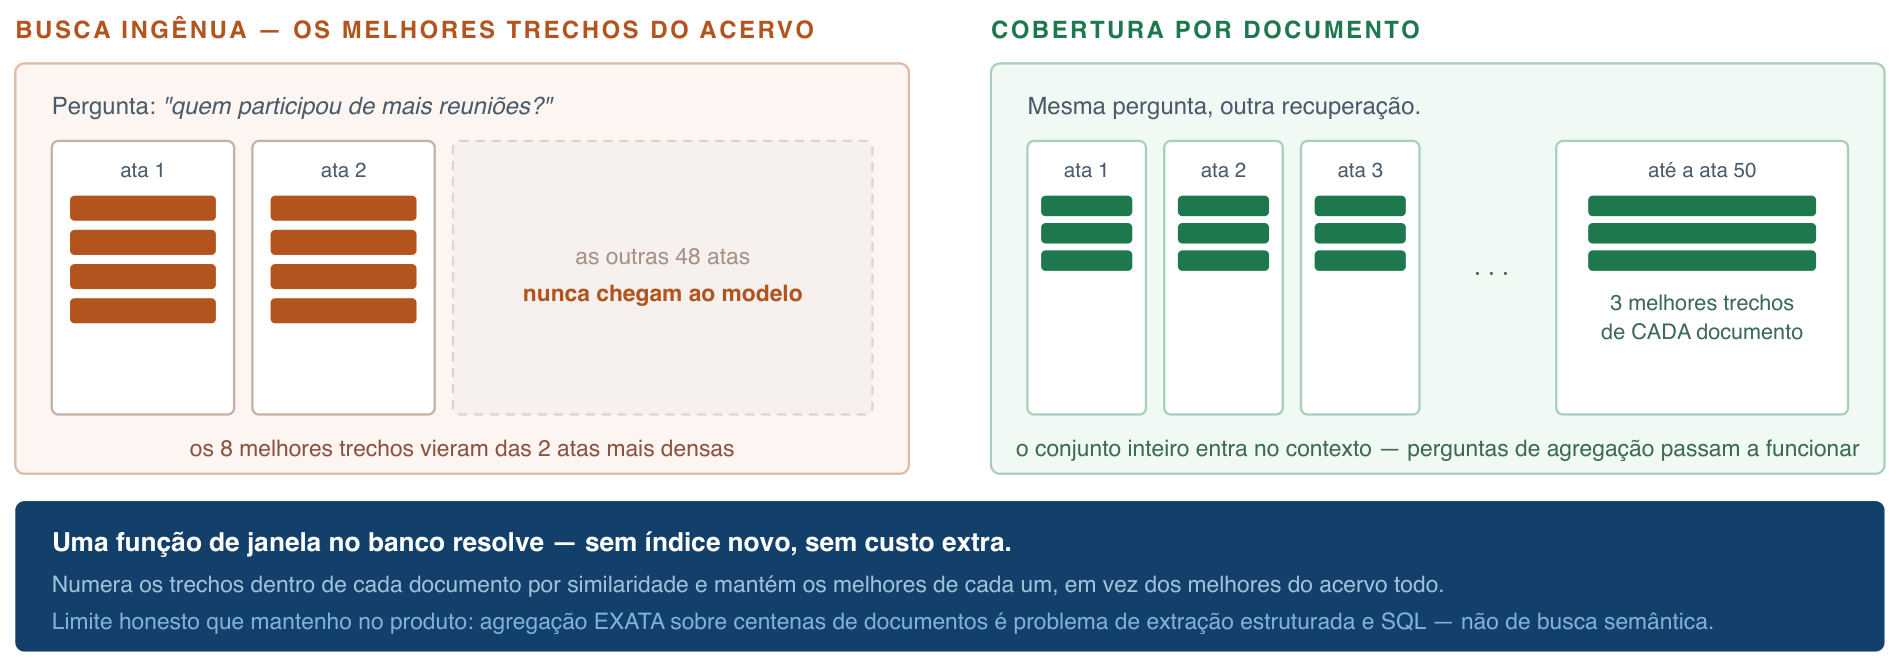
A alternativa apresentada é ordenar os trechos dentro de cada documento e selecionar os melhores de cada um. O exemplo utiliza três trechos por ata. Uma função de janela no banco permite realizar essa seleção sem criar um índice adicional para essa finalidade.
A mudança evita que poucos documentos monopolizem o contexto, mas aumenta a quantidade potencial de texto recuperado. Ainda é necessário administrar o limite de contexto e o custo das consultas. Também não há garantia de que os três trechos escolhidos contenham todos os participantes relevantes de cada reunião.
Para agregações exatas sobre grandes conjuntos, o próprio autor estabelece outro caminho: extração estruturada e consultas SQL. Uma contagem verificável depende de reunir os registros necessários, tratar duplicidades e definir a regra de cálculo. Similaridade semântica ajuda a encontrar evidências; não substitui esse processamento.
Respostas úteis precisam de fontes e de limites explícitos
No desenho apresentado, o modelo recebe os trechos recuperados, numerados e acompanhados de arquivo e página. Ele não consulta diretamente o banco de vetores. Essa separação permite que o servidor controle o conjunto entregue para a geração.
As instruções exigem referências nas afirmações e admitem a resposta “não encontrei”. A temperatura é configurada em zero para reduzir a variabilidade. São escolhas destinadas a tornar a resposta mais verificável, mas não eliminam a possibilidade de erro: um número de citação pode apontar para um trecho que não sustenta a afirmação.
Por isso, a referência precisa levar o usuário ao ponto de conferência. Saber apenas o nome do arquivo pode ser insuficiente em um documento extenso. A indicação da página e do trecho permite examinar a relação entre a resposta e sua evidência.
Também convém delimitar o alcance da conclusão. Se o contexto recuperado não cobriu todo o acervo, a ausência de um resultado deve ser descrita em relação aos documentos ou trechos consultados. “Não encontrado na recuperação” e “inexistente no acervo” não são afirmações equivalentes.
Cada consulta deixa um registro de usuário, momento, escopo e conteúdo pesquisado, segundo a fonte. Esse histórico ajuda a investigar acessos e reconstruir operações. Ele também pode conter dados pessoais inseridos na pergunta, de modo que sua proteção e retenção precisam integrar a governança da própria busca.
Retenção, isolamento e direitos precisam alcançar todos os derivados
Um documento processado pode gerar vários objetos: o original, imagens de trabalho, texto de OCR, versão tratada, trechos de pesquisa, vetores, metadados das remoções e registros de auditoria. Cada um precisa ter uma finalidade e um ciclo de vida definidos.
O sistema apresentado utiliza prazos distintos para alguns desses componentes:
Esses prazos são escolhas da implementação relatada. Não são prazos gerais estabelecidos pela LGPD ou pelo GDPR. Sua adoção em outro ambiente exige examinar finalidade, obrigações aplicáveis, riscos e necessidades documentais.
A relação entre os prazos também precisa ser compreendida. Se o índice expira junto com o original, mas a versão tratada permanece por um ano, a disponibilidade da pesquisa não acompanha necessariamente a disponibilidade desse arquivo. A organização deve saber quais funções continuarão acessíveis em cada etapa.
Preservar evidência da operação não autoriza guardar qualquer dado
A proposta do autor é permitir a eliminação do conteúdo quando cabível e conservar um registro minimizado do que foi realizado. Isso ajuda a distinguir a informação tratada da evidência de que houve uma operação.
O direito à eliminação, entretanto, não é absoluto. Na LGPD, os artigos 16 e 18 precisam ser considerados conjuntamente, incluindo as hipóteses de conservação. Uma trilha não fica automaticamente fora da lei por ser chamada de anonimizada: seu conteúdo e sua finalidade precisam justificar a retenção. 2 O artigo 17 do GDPR também prevê exceções, inclusive para obrigações legais e determinadas finalidades de arquivo, sob as condições aplicáveis.
O histórico deve permitir compreender a decisão sem reconstruir desnecessariamente o dado removido. Referências a documento, versão, operação e resultado podem ser mais adequadas do que copiar o conteúdo pessoal para mensagens de erro ou campos de observação.
O isolamento entre organizações acompanha esse ciclo. Original, versão tratada e índice não podem ter fronteiras de acesso contraditórias. Excluir ou restringir o arquivo principal enquanto os trechos permanecem consultáveis deixa uma parte do tratamento sem o controle esperado.
Preservação digital exige distinguir o original da cópia de acesso
Para instituições arquivísticas e órgãos públicos, a discussão não termina na configuração de um prazo de exclusão. É necessário distinguir a produção de uma versão para acesso da destinação do documento arquivístico original.
A Lei nº 8.159/1991 prevê preservação definitiva para documentos de valor permanente e condiciona a eliminação de documentos produzidos por instituições públicas e de caráter público à autorização da instituição arquivística competente. Portanto, uma política de expiração do software não pode decidir essa destinação sozinha. 7
Como implicação para a gestão do acervo, a versão tratada deve manter uma relação documentada com sua origem: qual documento a gerou, qual versão foi utilizada e quais operações produziram a cópia. O acesso ao original, quando sua guarda for devida, permanece sujeito às condições apropriadas.
Essa separação permite conciliar proteção e continuidade documental. A cópia pode ter conteúdo suprimido para determinada finalidade de acesso, enquanto o original segue o regime de guarda aplicável. Não se deve presumir que o tratamento da cópia autorize destruir a evidência documental de origem.
Os limites que precisam aparecer no projeto
O PDF dedica uma seção ao que a solução não resolve. Essa delimitação ajuda a planejar o trabalho e evita avaliar o sistema apenas pelos exemplos em que a detecção funcionou.
A qualidade da imagem limita a detecção
Uma fotografia tremida, um carimbo sobreposto ao texto ou uma digitalização de baixa qualidade podem impedir a leitura correta. A fonte cita digitalizações a 150 dpi como exemplo de dificuldade; a resolução, isoladamente, não determina o resultado, pois contraste, tamanho dos caracteres e ruído também interferem na legibilidade.
A correção de OCR e a tarja manual oferecem respostas para parte desses problemas. Mesmo assim, uma informação que não foi reconhecida pode continuar visível na imagem. A revisão precisa considerar a página, não apenas a lista de ocorrências produzida pelo sistema.
Nomes continuam dependentes de contexto
Um nome de pessoa não possui uma regra de verificação comparável à de um CPF. A mesma palavra pode aparecer como sobrenome, nome de rua, instituição ou expressão comum. A interpretação exige examinar a relação entre os termos e a função daquele trecho.
Por isso, automatizar a localização não elimina a necessidade de corrigir classificações. A capacidade de explicar por que uma ocorrência foi sugerida e de registrar sua rejeição é particularmente útil nessa categoria.
Identificadores indiretos podem sobreviver às tarjas
O exemplo do único servidor de um setor em determinado ano mostra por que remover nomes não encerra a análise. Cargo, local, data, evento e outras características podem permitir identificação quando combinados.
A avaliação precisa perguntar o que um destinatário poderia inferir a partir do documento e de informações razoavelmente disponíveis. Dependendo do caso, o problema estará no conteúdo que permaneceu, mesmo que todas as remoções selecionadas tenham sido executadas corretamente.
Planilhas e bancos de dados exigem outra abordagem
O sistema apresentado é voltado à anonimização documental. Bases estruturadas acrescentam relações entre registros, distribuições e combinações de atributos que não se resolvem apenas com tarjas em páginas.
A fonte aponta generalização, supressão e introdução de ruído como famílias de técnicas que podem ser consideradas nesse outro contexto. Sua escolha depende da finalidade analítica e do risco de identificação. Transportar diretamente a lógica de um PDF para uma tabela pode tanto deixar dados expostos quanto destruir a utilidade da base.
Dez perguntas para fazer a qualquer fornecedor
- O documento original chega ao navegador antes de ser tarjado? Se chega, há uma cópia a mais do dado íntegro fora do servidor.
- A tarja remove o texto ou desenha por cima? Peça o PDF e tente copiar.
- Existe verificação automática depois da remoção? E o que acontece se sobrar vestígio.
- Cada dado vem com tipo e base legal? Sem distinguir Art. 5º de Art. 11, não há como demonstrar a hipótese.
- Dá para saber se veio de regra ou de IA? E com que confiança.
- A decisão final é humana e registrada item a item?
- Detecta o que não é texto? Rosto, assinatura e carimbo são dado pessoal.
- O índice de busca contém PII? Vetor derivado de texto com CPF carrega o CPF.
- O que o sistema guarda para aprender? Se guarda o valor, acumula o que deveria eliminar.
- Qual o custo por documento em escala? Controle caro vira controle por amostragem.
Essas perguntas funcionam melhor quando aplicadas a um conjunto de teste representativo: documentos legíveis e difíceis, nomes repetidos, informações em imagens, falhas de OCR e ocorrências que devem permanecer. Um resultado favorável em um único contrato demonstra apenas aquele caso.
Proteção documental se comprova ao longo de todo o percurso
A contribuição da arquitetura apresentada está na conexão entre etapas que muitas vezes são avaliadas separadamente. A detecção produz hipóteses. A revisão decide. A transformação executa. A verificação condiciona a entrega. A indexação precisa refletir as mesmas decisões, e a retenção deve alcançar os objetos derivados.
Quando essas etapas usam referências e versões coerentes, a organização consegue investigar por que um dado foi removido, por que outro permaneceu e qual conteúdo sustentou uma resposta de busca. O sistema passa a produzir evidências do processo, além do documento final.
Para a preservação digital, esse controle também permite distinguir o original de uma cópia destinada a determinado acesso. Proteção de dados e continuidade documental exigem decisões articuladas sobre guarda, transformação e disponibilização.
O teste decisivo é acompanhar o dado em todo esse percurso. Se ele desaparece da página, mas permanece recuperável no arquivo, no índice ou em um registro desnecessário, o problema continua. Uma operação confiável precisa demonstrar o que removeu, conservar justificadamente o que deve guardar e reconhecer os riscos que a automação não consegue resolver sozinha.
Fontes e créditos
[1] Fonte principal. BRITO, Danilo Siqueira. Anonimização de documentos com IA: como construí um sistema para LGPD e GDPR. PDF fornecido, 32 páginas. Todas as 15 figuras deste artigo foram reproduzidas do material, preservando as proteções visuais existentes. As dez capturas ou interfaces ilustradas e os diagramas relevantes foram integrados ao texto. As páginas compostas apenas por títulos, explicações ou elementos decorativos foram desenvolvidas em prosa, sem reproduzir slides inteiros.
[2] Brasil. Lei nº 13.709/2018, Lei Geral de Proteção de Dados Pessoais, texto compilado. Referência para anonimização, necessidade e condições de conservação e eliminação.
[3] União Europeia. Regulamento (UE) 2016/679, GDPR. Considerandos 26 e 51 e artigos 4º e 17.
[4] ANPD. Perguntas frequentes sobre proteção de dados pessoais. Referência para conceito de dado pessoal, alcance da proteção e hipóteses de tratamento.
[5] PyMuPDF. Documentação de `Page.apply_redactions`. Complemento técnico sobre aplicação de remoções e condições de salvamento.
[6] Anthropic. Tabela oficial de preços da API Claude. Conferência dos preços dos modelos citados no PDF e das modalidades de cache.
[7] Brasil. Lei nº 8.159/1991. Artigos 8º a 10, sobre documentos permanentes e eliminação de documentos públicos.
Referências complementares consultadas em 26 de setembro de 2026. O PDF é a fonte central das explicações sobre o sistema. Os complementos esclarecem a terminologia jurídica, as condições técnicas e a relação com a gestão arquivística.
Quer conversar sobre anonimização em escala?
Vamos avaliar como seu acervo está e o que é necessário para passar numa auditoria.